 (81) 99164-5340
 (81) 3228-0919
Durante muito tempo, quando se falava em processamento de dados, a ideia era relativamente simples: o dispositivo produzia uma informação, enviava tudo pela internet para um servidor distante e aguardava a resposta. Esse modelo continua sendo usado em praticamente todos os serviços digitais que conhecemos, mas começa a encontrar limitações à medida que a quantidade de dados cresce.
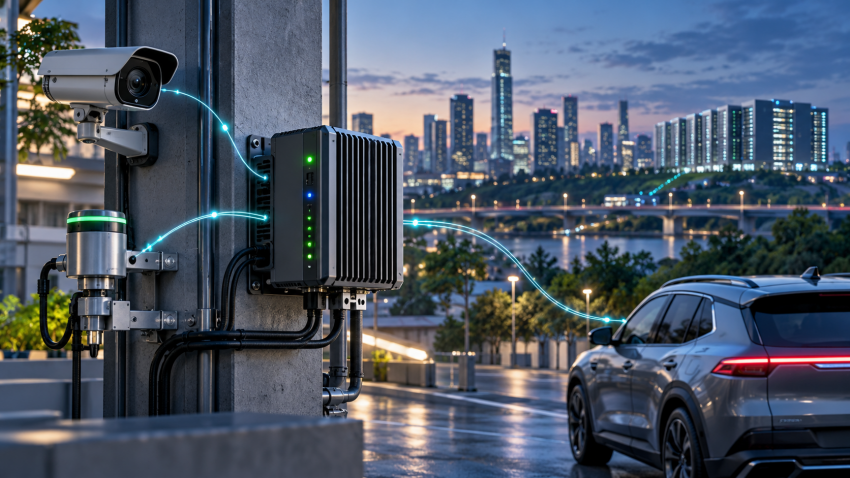
Câmeras de segurança, carros conectados, fábricas automatizadas, sensores, smartphones e dispositivos de Internet das Coisas produzem informações o tempo inteiro. Mandar absolutamente tudo para um data center distante pode consumir muita banda, aumentar o tempo de resposta e criar uma dependência constante da conexão com a internet.
É nesse cenário que aparece o Edge Computing, ou Computação na Borda.
A ideia central é aproximar o processamento dos dados de onde eles são produzidos.
O que significa “computação na borda”?
O nome pode parecer complicado, mas o conceito é relativamente fácil de entender.
Imagine uma câmera instalada em uma fábrica. Ela pode produzir milhares de imagens por minuto. Em um modelo tradicional, essas imagens poderiam ser enviadas para um servidor central para serem analisadas.
Com Edge Computing, parte dessa análise pode acontecer em um computador ou equipamento instalado próximo à câmera.
Em vez de enviar todas as imagens para longe, o sistema pode identificar localmente o que realmente importa. Se a câmera detectar uma pessoa entrando em uma área proibida, por exemplo, pode enviar apenas o evento, uma imagem ou um pequeno trecho de vídeo para o servidor central.
O processamento aconteceu na “borda” da rede, próximo da origem do dado.
Isso não significa que os data centers deixaram de ser importantes. Eles continuam sendo fundamentais. A diferença é que determinadas tarefas passam a ser executadas mais perto do usuário ou do equipamento que produz os dados.
Por que não fazer tudo na nuvem?
A computação em nuvem trouxe uma série de vantagens. Empresas não precisam manter grandes estruturas próprias de servidores e podem contratar capacidade computacional conforme a necessidade.
O problema aparece quando determinadas aplicações precisam de respostas extremamente rápidas.
Imagine um equipamento industrial responsável por interromper uma máquina quando identifica uma situação perigosa. Se cada decisão depender de uma conexão com um servidor localizado a centenas ou milhares de quilômetros, qualquer atraso pode ser relevante.
Com processamento local ou próximo, a informação percorre uma distância menor.
É aí que entra uma das principais vantagens do Edge Computing: reduzir a latência.
Latência é o tempo necessário para uma informação ir de um ponto a outro e receber uma resposta. Em uma chamada de vídeo, alguns milissegundos provavelmente não fazem diferença. Em determinados sistemas industriais, veículos autônomos ou aplicações de realidade aumentada, podem fazer.
Como funciona na prática?
Uma arquitetura de Edge Computing pode assumir diferentes formatos.
Pode existir um pequeno servidor dentro de uma empresa, um equipamento instalado em uma fábrica, um gateway conectado a sensores ou até infraestrutura localizada próxima a uma estação de telecomunicações.
O princípio é semelhante.
O dispositivo gera dados. Em vez de mandar necessariamente tudo para um data center distante, parte do processamento acontece perto da origem. Depois, apenas as informações necessárias podem seguir para sistemas centralizados.
Um exemplo simples seria uma loja equipada com dezenas de câmeras.
Em vez de transmitir continuamente todas as imagens para a nuvem, um sistema local pode analisar os vídeos. Ele pode identificar movimentação, contar pessoas ou detectar determinadas situações.
A nuvem recebe os resultados relevantes, enquanto o processamento pesado inicial acontece localmente.
Edge Computing e Internet das Coisas
A expansão da Internet das Coisas é um dos fatores que ajudam a explicar o crescimento do Edge Computing.
Um sensor isolado produz poucos dados. Mas imagine uma fábrica com milhares deles funcionando simultaneamente.
Temperatura, vibração, pressão, velocidade, consumo de energia e outras informações podem ser coletadas continuamente.
Enviar tudo para um servidor remoto pode exigir uma infraestrutura de rede considerável.
Com Edge Computing, equipamentos próximos podem filtrar e processar essas informações antes de enviá-las para a nuvem.
Um sensor pode produzir milhares de registros, mas o sistema pode concluir que apenas alguns eventos precisam ser armazenados permanentemente.
Isso reduz o volume de dados que precisa viajar pela rede.
Edge Computing não significa abandonar a nuvem
Existe uma ideia equivocada de que Edge Computing seria uma espécie de substituição da computação em nuvem.
Na realidade, os dois modelos podem trabalhar juntos.
A borda pode cuidar de tarefas que precisam de velocidade ou processamento local, enquanto a nuvem continua responsável por armazenamento, análise histórica, treinamento de modelos de inteligência artificial, gerenciamento e outras atividades.
Uma fábrica, por exemplo, pode analisar imediatamente os sensores usando computadores locais e, ao mesmo tempo, enviar os dados consolidados para a nuvem.
Assim, os operadores conseguem reagir rapidamente a um problema e, posteriormente, a empresa pode analisar meses de informações para descobrir padrões.
É uma divisão de responsabilidades.
Inteligência Artificial também está indo para a borda
O crescimento da inteligência artificial tornou o Edge Computing ainda mais relevante.
Muitos dispositivos já possuem capacidade suficiente para executar modelos de IA localmente.
Um celular pode reconhecer uma voz, identificar objetos em uma fotografia ou realizar determinadas funções de inteligência artificial sem precisar enviar cada informação para um servidor distante.
O mesmo princípio pode ser aplicado a câmeras, veículos, máquinas industriais e outros equipamentos.
Essa abordagem é conhecida como Edge AI.
Além da velocidade, existe outra vantagem: privacidade.
Quando uma determinada informação pode ser processada diretamente no dispositivo, não é necessariamente necessário enviar o dado bruto para um servidor externo.
Isso pode ser especialmente interessante quando estamos falando de imagens, áudio ou outras informações potencialmente sensíveis.
Segurança também muda
A descentralização traz benefícios, mas cria novos desafios.
No modelo tradicional, uma empresa pode concentrar boa parte de sua infraestrutura em alguns data centers e aplicar políticas de segurança nesses ambientes.
No Edge Computing, podem existir dezenas, centenas ou milhares de pontos de processamento espalhados fisicamente.
Cada um deles precisa ser protegido.
Um equipamento instalado em uma fábrica, por exemplo, pode estar em um ambiente onde existe acesso físico de funcionários, fornecedores e técnicos.
Se ele estiver mal configurado ou sem atualizações, pode se transformar em um ponto de entrada para ataques.
Por isso, Edge Computing exige cuidados com autenticação, criptografia, atualizações, controle de acesso e monitoramento.
Quanto maior a quantidade de equipamentos espalhados pela borda da rede, maior também é o desafio de administrar todos eles.
E o 5G?
Edge Computing e 5G costumam aparecer juntos porque existe uma relação importante entre as duas tecnologias.
As redes 5G foram projetadas para oferecer maior capacidade, menor latência e suporte a uma grande quantidade de dispositivos conectados.
Isso cria condições interessantes para aplicações que precisam trocar dados rapidamente.
Em alguns cenários, recursos de processamento podem ser posicionados próximos às redes de acesso. Dessa forma, o dispositivo não precisa necessariamente enviar a informação até um data center muito distante.
Essa combinação pode ser útil em áreas como indústria, logística, veículos conectados, cidades inteligentes e realidade aumentada.
Onde veremos Edge Computing?
Na prática, talvez você já esteja utilizando tecnologias que dependem parcialmente desse conceito sem perceber.
Sistemas de videomonitoramento, automação industrial, veículos conectados, redes de telecomunicações, dispositivos inteligentes e aplicações de inteligência artificial podem utilizar processamento na borda.
Em uma casa inteligente, por exemplo, alguns dispositivos podem executar determinadas automações localmente. Isso permite que uma função continue funcionando mesmo quando a conexão com a internet apresenta problemas.
No setor industrial, a aplicação pode ser ainda mais significativa. Máquinas podem analisar seus próprios sensores e identificar sinais de desgaste antes que uma falha aconteça.
Em hospitais, equipamentos podem processar determinados dados próximos ao local onde são coletados. Em lojas, câmeras e sensores podem analisar o ambiente em tempo real.
O potencial está justamente na variedade de situações.
A internet está ficando mais distribuída
Durante anos, a evolução da internet foi associada principalmente ao aumento da velocidade das conexões e à expansão dos grandes data centers.
Agora, outra transformação acontece de maneira menos visível.
Parte do processamento está se espalhando pela rede.
A lógica é simples: nem toda informação precisa viajar até o outro lado do mundo para ser processada.
Quando uma decisão precisa ser tomada rapidamente, faz sentido colocar capacidade computacional próxima de onde o dado nasce.
Quando é necessário armazenar grandes volumes de informações ou realizar análises mais complexas, a nuvem continua tendo seu papel.
O futuro provavelmente não será exclusivamente baseado na nuvem nem exclusivamente na borda. Será uma combinação dos dois modelos, com cada camada assumindo as tarefas para as quais é mais adequada.
No fim das contas, Edge Computing representa uma mudança de perspectiva. Em vez de pensar na internet apenas como um caminho que leva nossos dados até grandes servidores, passamos a enxergá-la como uma estrutura distribuída, na qual processamento, armazenamento e inteligência podem existir em vários pontos.
E quanto mais dispositivos estiverem conectados, mais importante será decidir não apenas onde os dados serão armazenados, mas também onde eles devem ser processados.
